
Underdog Pamerkan Model Suara 32MB dalam Demo Terbaru
Underdog membuat gebrakan di dunia kecerdasan buatan dengan merilis model suara berukuran sangat kecil yang mampu menghasilkan audio berkualitas.
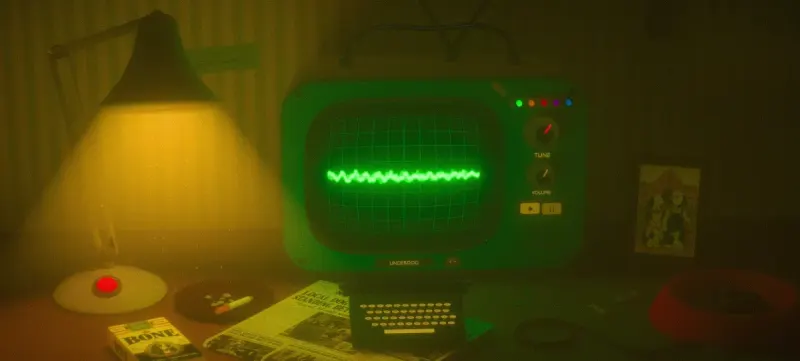
Inovasi Ringan dari Underdog
Dunia teknologi kecerdasan buatan baru saja dikejutkan oleh sebuah terobosan menarik dari Underdog. Melalui demo terbaru yang mereka bagikan, perusahaan ini membuktikan bahwa efisiensi tidak selalu harus mengorbankan performa. Mereka berhasil memperkenalkan sebuah model suara yang hanya berukuran 32MB, sebuah angka yang sangat kontras jika dibandingkan dengan model-model bahasa besar yang biasanya memakan ruang penyimpanan hingga bergiga-giga.
Kemampuan yang Mengejutkan
Meskipun ukurannya sangat ringkas, model ini tidak bisa dipandang sebelah mata. Berdasarkan laporan dari TechCrunch, Underdog telah menunjukkan bahwa teknologi ini memiliki fleksibilitas yang luar biasa. Model tersebut tidak hanya terbatas pada sintesis suara manusia, tetapi juga mampu menghasilkan komposisi musik secara mandiri.
Mengapa Ukuran Kecil Itu Penting?
Kehadiran model dengan ukuran 32MB membuka pintu bagi berbagai kemungkinan baru dalam pengembangan aplikasi. Berikut adalah beberapa alasan mengapa inovasi ini dianggap krusial:
- Efisiensi Perangkat: Model yang ringan memungkinkan integrasi langsung ke perangkat seluler tanpa harus bergantung pada koneksi awan yang berat.
- Kecepatan Pemrosesan: Dengan ukuran yang minimalis, waktu respons yang dibutuhkan untuk menghasilkan suara atau musik menjadi jauh lebih cepat.
- Aksesibilitas: Pengembang dengan sumber daya terbatas kini memiliki kesempatan untuk memanfaatkan teknologi canggih tanpa memerlukan infrastruktur server yang mahal.
Langkah yang diambil oleh Underdog ini memberikan sinyal kuat kepada industri bahwa masa depan kecerdasan buatan tidak hanya terletak pada skala parameter yang masif, tetapi juga pada optimalisasi yang cerdas. Dengan kemampuan menghasilkan suara dan musik dalam satu paket yang sangat kecil, Underdog telah menetapkan standar baru bagi efisiensi model bahasa di masa depan.
Tentu saja, tantangan ke depan adalah bagaimana menjaga kualitas output tetap konsisten saat model ini diuji dalam berbagai skenario yang lebih kompleks. Namun, untuk saat ini, demo yang ditampilkan telah berhasil menarik perhatian banyak pihak dan membuktikan bahwa inovasi besar bisa datang dalam kemasan yang sangat kecil.
Berita Terkait
 AI
Nvidia: Dua Sisi Mata Uang Raksasa Teknologi
Nvidia kini berada di persimpangan jalan. Laporan keuangan yang gemilang berbenturan dengan kritik tajam dari para eksekutif tekn…
20 jam lalu · TechCrunch
 AI
Signal Batasi Screenshot demi Hadapi Ancaman AI
Signal mengambil langkah drastis dengan membatasi fitur tangkapan layar di perangkat seluler sebagai upaya melindungi privasi pen…
23 jam lalu · TechCrunch
 AI
Jual Wajah ke Startup AI: Masa Depan Hollywood?
Tren lisensi wajah untuk drama pendek berbasis AI kini merambah industri hiburan. Apakah ini inovasi atau ancaman bagi masa depan…
1 hari lalu · TechCrunch